
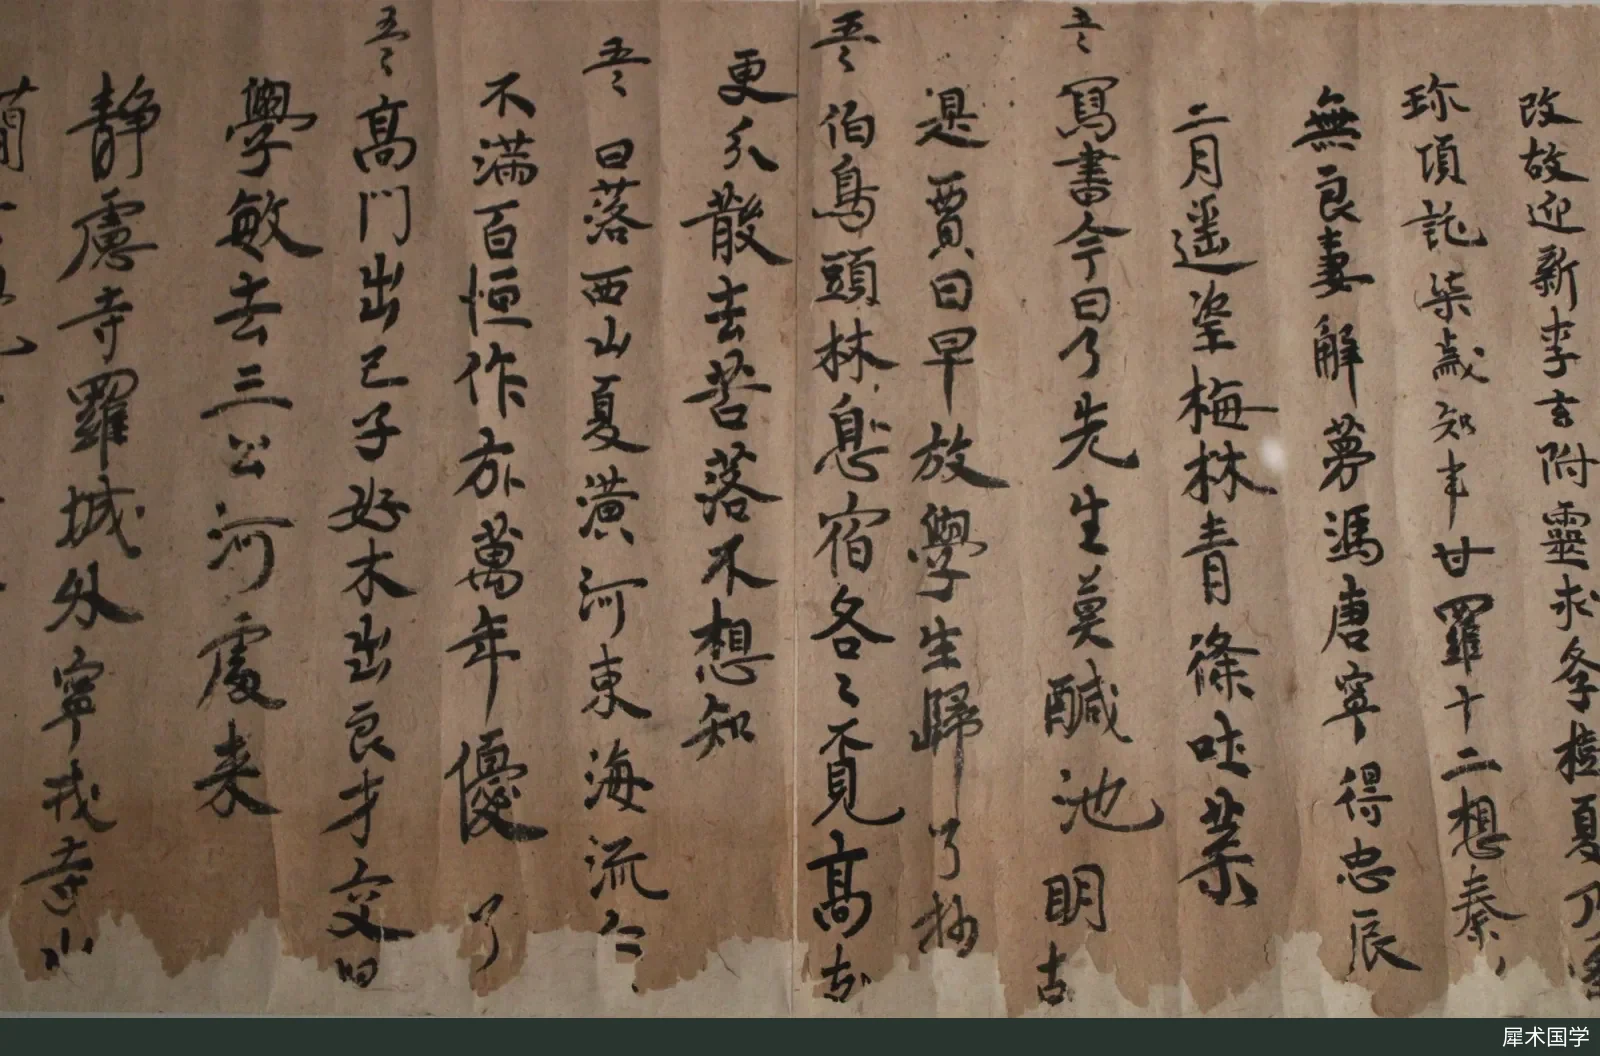
唐写本《论语》郑玄注残卷。据 Wikimedia Commons 文件说明,系 12 岁学生卜天寿于 710 年抄写,出土于新疆吐鲁番阿斯塔那 363 号墓,原件藏吐鲁番博物馆。照片:Zunkir,来源 Wikimedia Commons,许可 CC BY-SA 4.0。

中国哲学书电子化计划(Chinese Text Project,ctext.org)2005 年上线,把不开放编辑的先秦两汉原典、可众包修订的维基转录和图书馆书影放在同一系统中,支持全文检索、平行文本、字典与 API。本文依据官网说明和创建者论文,梳理各功能的用法、可靠性边界与免费、订阅差异,并给出三个可复用的检索示例。
收录范围与可靠性分层
按创建者教程对标题检索结果图标的说明,ctext 的材料分四类:原典资料库中的转录(用户不能编辑)、用户可编辑但非 OCR 生成的转录、由 OCR 生成的可编辑转录,以及某一具体版本的扫描书影。原典资料库以先秦两汉文献为核心,平行文本、引得编号和部分注疏功能都集中在这里;后三类分布在维基区和图书馆区。规模方面,Sturgeon 2019 年在线发表的论文称系统已有逾 2500 万页书影、逾 50 亿字转录、每日逾 3 万名用户,这是论文撰写时的数字,现况以官网首页为准。
书影主要来自与大学图书馆和扫描中心的合作,论文点名的有哈佛燕京图书馆、普林斯顿大学图书馆和香港中文大学图书馆。官网首页 2016 年 10 月 10 日的更新记录称,哈佛燕京图书馆逾 500 万页中文藏书扫描(含中文善本特藏的高清影像)加入图书馆区,同时用 ctext 的 OCR 生成近似转录放入维基区,使这些书可以全文检索。
维基区的可靠性边界需要单独记住。官网介绍页说明,维基区收有数千种历代传世文献,用户可协作修改;这些文本可能未经编辑审校、可能有错,应与标明的底本对照。论文进一步说明,OCR 转录一经生成就直接公开,修改提交后立即生效,论文撰写时每天约有百次编辑,每次修改都有版本记录,可在 History 页比对或回退。换句话说,维基文本是一份持续施工的工作本:适合找线索、定位书影,不宜不经核对就当作引文底本。
英文对照译文同样分两类。官网翻译说明称,一类是已出版的完整译本,不能编辑;另一类是在 ctext 上用 AI 加众包生成的译文,可以修改。首页 2026 年 3 月 1 日的更新记录称,先秦两汉中原本缺译的文本、二十五史及数百种其他典籍已加入 AI 译文,并明言 AI 译文不可避免会有错误,因此逐句与原文对齐以便核查纠错;不想显示译文时,可在页面顶部的翻译设置中选择 None。引用译文时应注明属于哪一类,经文理解仍以原文和历代注疏为准。
据此,本文的引用建议是:引原典资料库文本时,同时核对该书页面的底本说明或对应书影,正式出版物仍以纸本整理本为准,并注明整理者、出版者、年份与页码;引维基转录或书影时,注明书影所属版本、馆藏与页码,并记下访问日期和页面 URN。论文与教程都没有逐书列出原典资料库的底本,这一点需要在具体书目页面上自行确认。
书影对照、检索与字典
全文检索在具体文本内进行:先用左栏的标题检索(Title search)打开某书或某章,再在左栏底部的 Search 框输入词句。原典资料库的结果较多时,可点右上角 Show statistics 查看命中在各篇的分布。书影的检索依靠与之关联的转录:在转录中搜到词句后,点段落左侧的书影图标,即跳到对应书影页;在图书馆区直接检索,结果与检索关联转录相同。论文把这种设计描述为同一底层数据的两种视图——按篇章段落排列的逻辑文本,和逐页、逐列对齐书影的转录——两者可互相跳转。
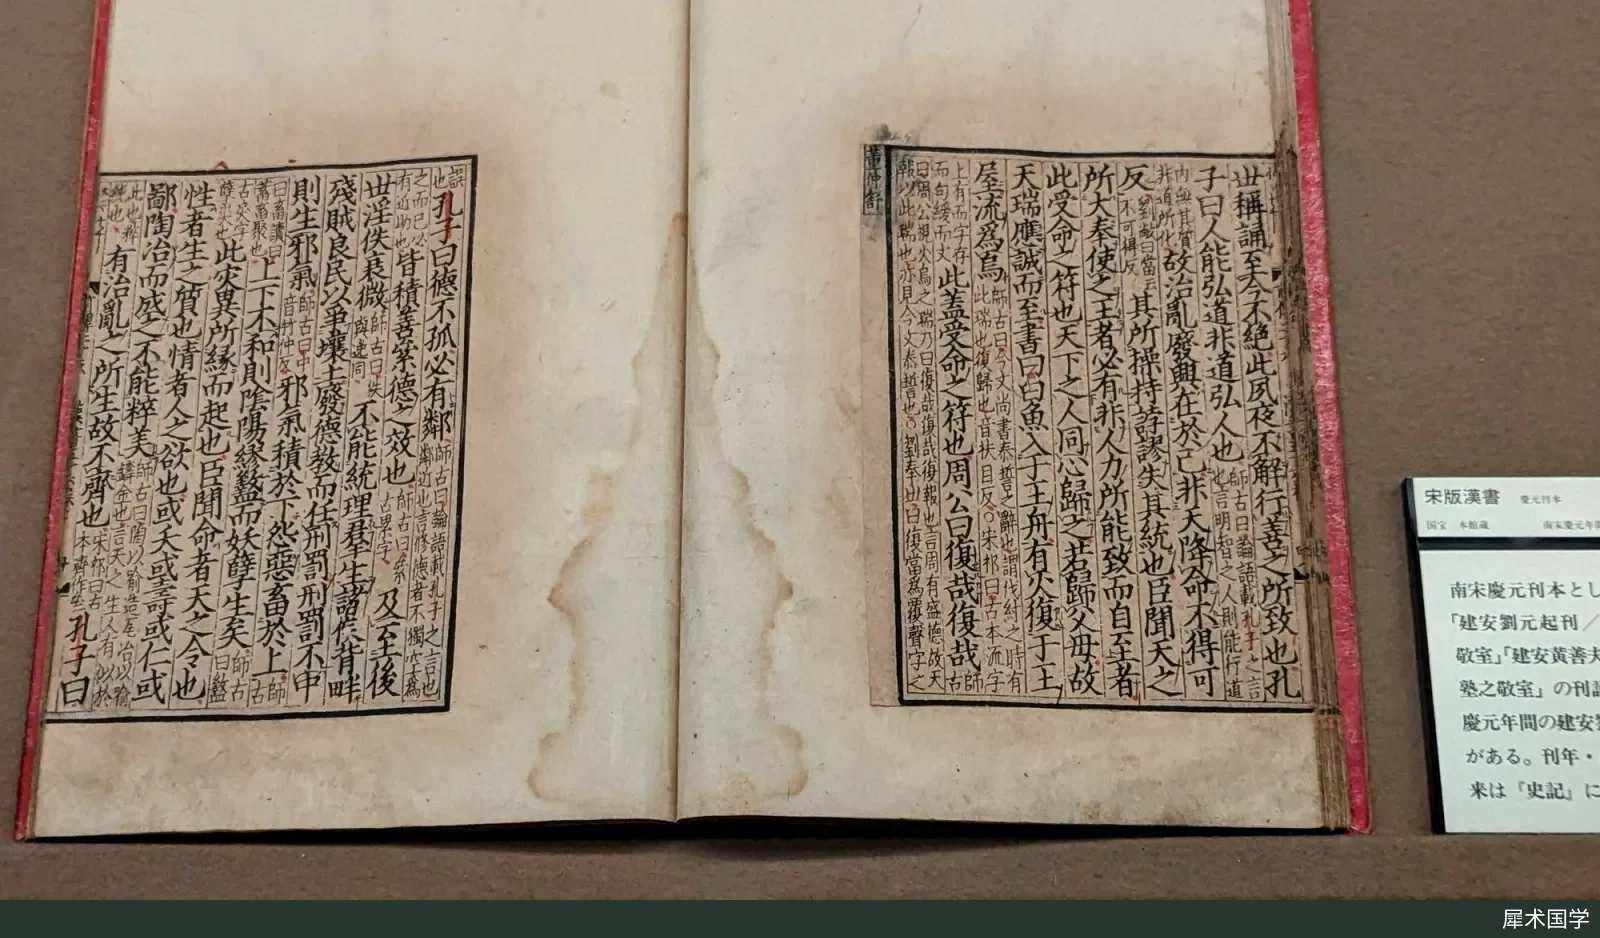
宋刻本《汉书》。据 Wikimedia Commons 文件说明与文件名,为南宋庆元年间(约 1195–1200 年)刊本,摄于日本国立历史民俗博物馆。刻本的版框、行格与竖排文字,就是 ctext“书影—转录”对照中转录所对应的书页形态。照片:Underbar dk,来源 Wikimedia Commons,许可 CC BY-SA 4.0。

对 OCR 转录,教程特别提醒:识别错误会使较长的词句搜不到,可改用较短片段,或改搜附近应出现的字词。
高级检索(左栏下方 Advanced search)分“检索范围”“检索参数”等区块,可把范围限定到某类、某书或某篇。平行文本功能仅适用于原典资料库中的先秦两汉文献和类书:在某段文字旁点平行文本图标,可看全库相似段落摘要;在高级检索中勾选 Parallel passage search,则可在两书或两类之间成批比对。官网介绍页指出,这类相同或近同的措辞可能说明一方有意抄录另一方,也可能只是两书都用了当时的熟语,所以平行结果是比对线索,不等于传承关系的结论。
字典区合并三类数据:Unicode 的 Unihan 数据库(部首笔画、异体、通行字典位置和偏重现代用法的英文释义)、古籍用例数据(Ancient Text Database)和 ctext 自建字典。自建字典把具体文本中的某个字与某一义项、读音手工做“语义链接”,并附带有译文的例句;官网说明这项工作耗时,覆盖范围仍有限。生僻字可直接输入,也可按部件或部首检字;尚未进入 Unicode 的字以 ctext:nnnn 形式的编号表示,复制到 Word 等软件时得到的是编号而非字形。
另有三项与经典阅读直接相关的功能。其一是逐句对照:点段落左侧图标,可把原文与英译按短语对齐,鼠标移过原文时显示字典信息。其二是注疏:教程列出《论语》《孟子》《墨子》《道德经》等书可在段旁展开注释,注释本身也是独立文本,可切换过去通读;教程没有写明所收注本,使用时应在页面上核对注家与版本。其三是引得编号:部分书(如《荀子》)支持按哈佛燕京学社引得或香港中文大学中国文化研究所(ICS)逐字索引的编号反查原文,便于核对只给编号、不引原文的论著。
三个可复用的检索示例
前两例改写自创建者教程中的练习,第三例依据 PyPI 上的 ctext 包说明。界面文字按英文界面写出,中文界面名称可能略有不同。
示例一:在单书内定位一句经文
- 左栏 Title search 输入“論語”,打开原典资料库中的《论语》。
- 在左栏底部 Search 框输入“君子不器”,结果定位到《为政》篇。
- 点该段左侧的对照图标,查看逐句英译与字典信息;结果较多时用 Show statistics 看分布。
复用方式:把书名换成《孟子》《荀子》等,把检索词换成要核对的句子。
示例二:两书或两类之间的平行文本
- 点左栏 Advanced search。
- 在“1. Scope”依次选 Pre-Qin and Han(先秦两汉)→ Confucianism(儒家)→ Analects(论语),第四栏保留 [All]。
- 在“3. Search parameters”勾选 Parallel passage search,再选 Pre-Qin and Han → Daoism(道家)。
- 点 Search,再点 Show statistics;然后把范围与参数对调重查,比较两次统计。
复用方式:换成任意两书或两类比对;结果只说明措辞相近,传承关系需另行论证。
示例三:用 Python 取回一章原文再筛选
from ctext import setlanguage, searchtexts, gettextasparagraphlist

setlanguage("zh")
# setapikey("your-api-key")  # some functions require an API key

print(searchtexts("論語"))
passages = gettextasparagraphlist("ctp:analects/xue-er")
for p in passages:
    if "君子" in p:
        print(p)
复用方式:URN 可在每个页面右下角查到,也可用 searchtexts() 取得;把 ctp:analects/xue-er(《论语·学而》)换成其他篇章即可。
API、Python 包与订阅边界
ctext 的 API 是一组返回 JSON 的 HTTP 接口,用 URN(如 ctp:analects)标识书、篇、段。论文说明,为防止单次请求压垮服务器,接口不会一次返回整部长书,而是返回下一级 URN 列表,由客户端逐级请求再拼接;Python 包里的 gettextasparagraphlist、gettextasstring 等函数就是替用户完成这种递归请求。PyPI 上的 ctext 包由 Sturgeon 发布,采用 MIT 许可,最新版 0.265 上传于 2017 年 11 月 10 日,说明中仍标注“实验性”;可用 setlanguage 设置界面语言,用 setremap("gb") 转为简体。
不写程序也能导出和分析:登录账户后,可在 About the site > Tools > Plugins 安装插件,如 Plain text 插件导出一章纯文本、Frequencies 插件查看字频;Text Tools 插件提供文本复用、正则表达式、n-gram 等分析与可视化。插件本身是 XML 描述文件,用户也可以自建。
免费与订阅的分界,现有官方资料只说到以下几点。网页阅读、检索和字典面向所有人免费开放,官网称机构订阅是目前唯一收入来源,用来维持免费访问。官网“数字人文”页称部分 API 功能需要机构订阅;PyPI 说明称获取整书完整结构、下载大量数据等函数可能需要 API key。机构订阅还附带使用条件:以香港教育大学图书馆公布的条款为例,API 可能设合理用量上限,协议终止后须删除大量下载的数据,不得系统性复制或转发网站内容、不得做替代 ctext 的服务;普林斯顿大学图书馆则说明校外使用 API 需经校园 VPN。订阅价格与免费 API 的具体额度,本文核对的资料均未公开,应以订阅页和所在机构图书馆的说明为准。
还有一条容易忽视的规则:官网明确说网页抓取违反服务条款,系统识别出抓取程序后会间歇性地故意返回错误数据。做字频统计或语料研究时,应通过 API 或机构订阅取数,不要用爬虫,否则结果可能被污染。